

Kinference schickt vLLM-Anfragen zu bereits geleisteter Arbeit
Die zweite Anfrage eines Gesprächs beginnt nicht bei null. Ein Worker im GPU-Pool hat womöglich schon fast den ganzen Verlauf verarbeitet. Geht die Fortsetzung woanders hin, wird diese Arbeit wiederholt.
Buoyant stellte Kinference am 4. November vor. vLLM führt weiterhin das Modell aus; Kinference entscheidet über das Ziel jeder Anfrage. Das ist für Coding-Sitzungen mit wiederkehrendem Projektkontext interessant. Ein gutes Ergebnis für ein Verkehrsmuster ist jedoch keine allgemeine GPU-Beschleunigung. NxCode hat die öffentlichen Unterlagen gelesen, Kinference aber weder installiert noch einen Cluster betrieben oder den Benchmark reproduziert.
Auch der nächste Gesprächsschritt hat einen Ort
Der KV-Cache hält Zwischenberechnungen der Aufmerksamkeit für bereits verarbeitete Token. Ein passendes Präfix wiederzuverwenden spart Prefill, also das Einlesen der Eingabe vor der Antwort. Fertige Antworten werden damit nicht gespeichert; die Fortsetzung muss weiterhin entstehen.
Laut Cache-Dokumentation beobachtet Kinference Cache-Inhalte und Last pro Worker. vLLM muss Cache-Ereignisse über ZMQ senden. Daraus entsteht eine Vorhersage der TTFT, der Zeit bis zum ersten Token, für jeden Kandidaten.
Ein Beispiel: Worker A hat die Projektbeschreibung im Cache, aber eine längere Schlange. B ist frei, muss den Anfang jedoch neu berechnen. Der Cache-Treffer allein entscheidet nicht, denn Warten kann teurer sein als Neuberechnung. Dieselben Gewichte und dieselbe Eingabe können durch andere Platzierung unterschiedlich viel Arbeit verursachen.
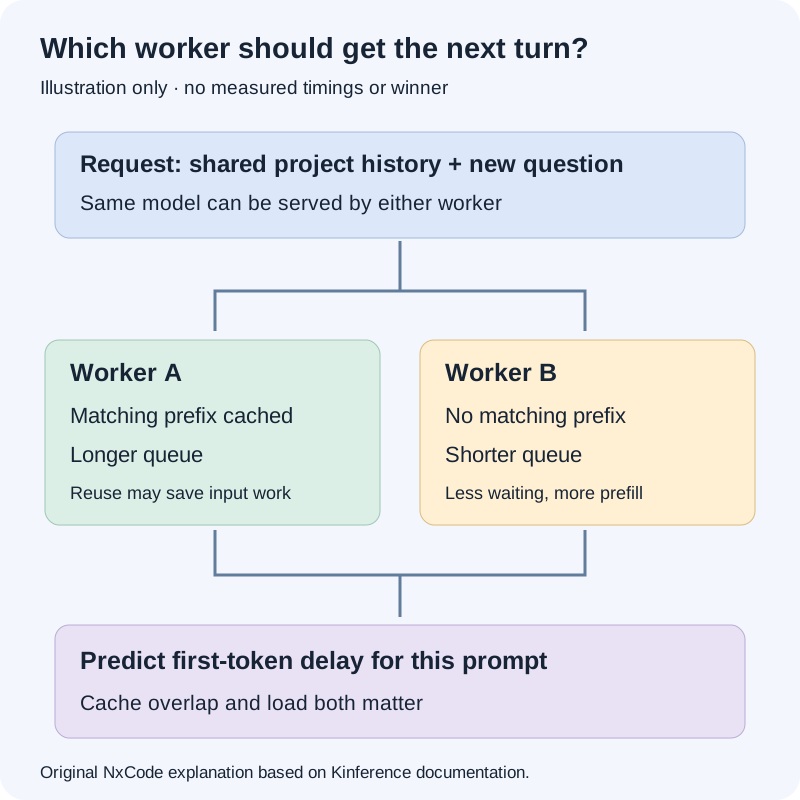
Abbildung: Eigene Erklärung von NxCode auf Grundlage der Kinference-Dokumentation. Die Worker sind ein Beispiel, keine Benchmark-Aufzeichnung und keine gemessene Routing-Entscheidung.
Die Schlagzeile braucht ihren Vergleich
Buoyants Benchmark nutzt zwei Pools mit jeweils drei L40S-GPUs, vLLM 0.31.0, Qwen-3.8-27B-FP8 und GuideLLM 0.8.1. Die Referenz ist ein Kubernetes Service mit zufälliger Pod-Wahl pro neuer Verbindung, kein anderer Cache-Router.
Der Anbieter meldet bei gemeinsamen Präfixen einen Rückgang der medianen TTFT von 6,88 auf 0,31 Sekunden und der Ende-zu-Ende-Latenz von 20,5 auf 11,3 Sekunden. Bei unabhängigen Eingaben bleibt die mediane TTFT praktisch gleich. Spitzen-Goodput steigt von 14 auf 103 Anfragen pro Minute, allerdings bei unterschiedlichen Nebenläufigkeiten. Goodput zählt nur Anfragen innerhalb des Latenzziels. Hier sollen 90 Prozent der ersten Token binnen acht Sekunden eintreffen; laut Buoyant ist das für interaktiven Chat ungeeignet.
Andere Hardware, kurze Eingaben, strengere Ziele oder ein vorhandener intelligenter Router ergeben einen anderen Versuch. Entscheidend ist zunächst, wie viel Kontext die eigenen Anfragen tatsächlich gemeinsam haben.
Das Gateway transportiert weiterhin die Anfrage
Die auf be2a7ad fixierte README beschreibt eine Steuerung neben einem Proxy wie Buoyant Gateway. Die gRPC-Schnittstelle liefert Ziel und gegebenenfalls veränderten Body. Sie ersetzt den Inferenzmotor nicht.
Der Anfrageablauf umfasst Body-Übertragung, Zielauswahl, Abruf des ausgehenden Bodys und Weiterleitung zum Worker. Anschließend meldet das Gateway erstes und letztes Token. So lässt sich die Vorhersage mit dem Ergebnis verbinden. Abschluss, Abbruch und zeitgesteuertes Aufräumen lösen den temporären Zustand einer Zuweisung auf.
Eine neue URL ist damit nur der für die App sichtbare Teil. Gateway, Router und Engine-Beobachtung müssen zusammenspielen. Die Architektur trennt Worker-Erkennung, Cache-Verfolgung, Bewertung und Kubernetes-Beobachtung. Eine GPU-Auslastungskurve beweist weder korrekten Präfixabgleich noch richtige Abschlussmeldungen.
Die Alpha kann weniger als die Produktbeschreibung
Die Seiten zu Token-Limits und semantischer Klassifikation nennen beide eine künftige Veröffentlichung. Die README warnt vor fehlender dauerhafter Produktionserfahrung und listet außerdem /v1/messages im Anthropic-Stil sowie mehrere Kinference-Replikate als fehlend. Letzteres betrifft die Steuerung, nicht die mehreren vLLM-Worker im Benchmark.
Gleichzeitig beschreibt die fixierte Architektur bereits eine Führungswahl unter Replikaten. Das ist ein Dokumentationskonflikt, kein Beleg für unterstützte Hochverfügbarkeit. Code, Entwurf und zugesagte Betriebsform können unterschiedlich weit sein.
Auch ein Policy-Beispiel mit einem Sensitivitätslabel belegt keinen ausgelieferten, zuverlässigen Klassifikator. Es zeigt die Entscheidung nach Vergabe des Labels, nicht dessen Genauigkeit. Dieser Text erklärt die Veröffentlichung, er empfiehlt keine selbst getestete Einführung. Quoten, Protokolle und Redundanz verlangen eine versionsbezogene Prüfung.
Ein Mandantenlabel ist keine Identitätsprüfung
Der Tenant-Leitfaden sagt, dass Kinference einem konfigurierten Header bedingungslos vertraut. Kann der Aufrufer ihn frei setzen, kann Nutzung dem falschen Team zugerechnet werden. Die Umgebung muss also eine vertrauenswürdige Identität liefern.
Auch die Standardwerte widersprechen sich: Der Leitfaden nennt standardmäßiges Tracking aller Tenants, die Metrikreferenz dagegen deaktivierte Tenant-Labels mit optionaler Allowlist. Sie schätzt ungefähr 91 Zeitreihen je Kombination aus Modell, Dienstgüteklasse und Tenant. Feinere Zuordnung belastet somit auch das Monitoring.
Wir wählen keinen dieser Standards als verifiziertes Verhalten aus. Version und Konfiguration müssen geklärt werden. Vorhandene Tenant-Metriken beweisen zudem keine durchgesetzten Nutzungslimits.
Eine erfolgreiche Antwort kann schlechter geroutet sein
Laut fixiertem Ablauf fällt die Bewertung auf Last allein zurück, wenn alle Tokenisierungspfade scheitern. Die Metriken zeigen Verfügbarkeit der Tokenisierung, degradierte Bewertung und vorhergesagte Latenz. Eine Textantwort kann also erfolgreich sein, obwohl Cache-Wissen fehlt. Fehlende Cache-Verbrauchsmeldungen sind ebenfalls nicht mit null Cache-Nutzung gleichzusetzen.
Für NxCode-Leser liegt hier die interessante Idee: Latenz gehört zur Reise einer Anfrage durch einen veränderlichen Pool, nicht nur zum Modellnamen. Kinference macht Teile davon sichtbar. Als Nächstes zählen ein klar unterstützter Versionsstand und Messungen auf einer anderen echten Last, die Antworterfolg und Routing-Qualität gemeinsam betrachten.
Quellen
- Kinference team: November 4 release.
- Kinference: cache-aware load balancing.
- Buoyant: published benchmark and conditions.
- Kinference: pinned README and limitations.
- Kinference: pinned request flow.
- Kinference: pinned architecture.
- Kinference: token limiting status.
- Kinference: semantic classification status.
- Kinference: tenant identification.
- Kinference: metrics reference.