

Kinference는 vLLM 요청을 이미 계산한 곳으로 보낸다
대화의 두 번째 요청은 빈 시스템에서 시작하지 않는다. GPU 풀의 한 worker가 이미 대부분의 기록을 처리했을 수 있다. 다음 턴을 다른 곳에 보내면 그 계산을 반복한다.
Buoyant가 11월4일 발표한 Kinference는 이 배치를 다룬다. 모델 실행은 vLLM이 맡고, Kinference가 요청의 목적지를 고른다. 프로젝트 맥락을 반복 전송하는 코딩 세션에서 의미가 있다. 다만 특정 트래픽의 개선이 모든 GPU의 가속을 뜻하지는 않는다. NxCode는 공개 자료를 읽었으며 설치, GPU 클러스터 운영, 벤치마크 재현은 하지 않았다.
다음 턴에도 위치가 있다
KV cache는 처리한 token의 attention 중간 계산을 저장한다. 일치하는 접두부를 재사용하면 답변 생성 전에 입력을 읽는 prefill을 줄인다. 완성된 답변을 저장하는 캐시가 아니므로 이어지는 텍스트는 생성해야 한다.
캐시 문서는 worker별 캐시와 부하 추적을 설명한다. vLLM은 ZMQ로 캐시 이벤트를 보내도록 설정해야 한다. Kinference는 특정 입력에 대해 각 목적지의 TTFT, 첫 token까지 걸릴 시간을 예측한다.
A에는 프로젝트 지침이 캐시돼 있지만 대기열이 길고, B에는 캐시가 없지만 여유가 있다고 하자. A를 기다리는 비용이 B에서 재계산하는 비용보다 클 수 있다. 캐시 적중만으로 선택할 수 없다. 같은 가중치와 입력도 배치에 따라 중복 계산량이 달라진다.
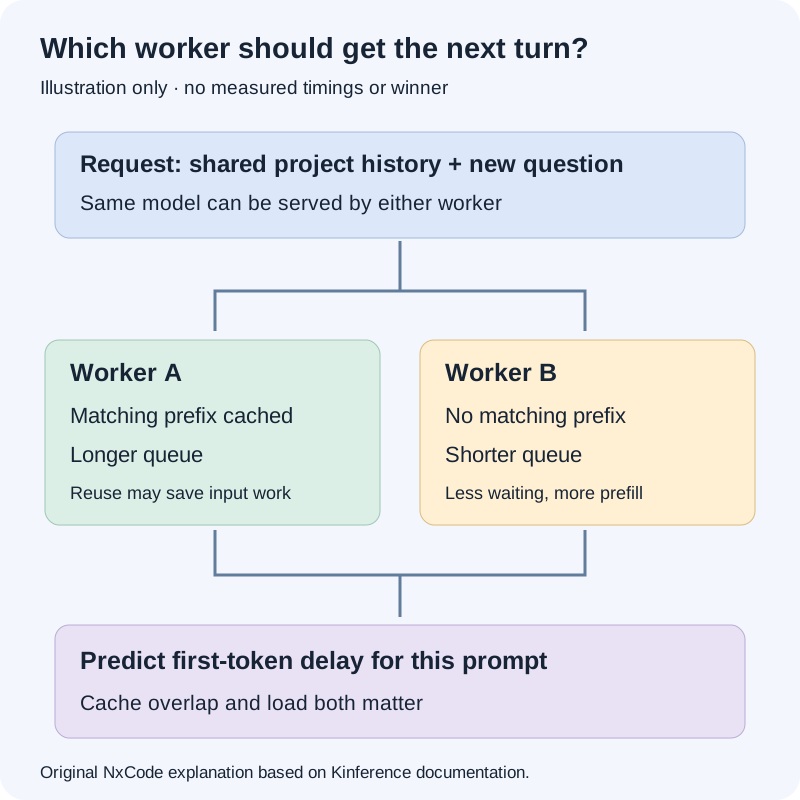
그림: Kinference 문서에 기반한 NxCode의 설명도. worker는 예시이며 벤치마크 기록이나 측정한 라우팅 결정이 아니다.
수치에는 비교 대상이 있다
Buoyant 벤치마크는 각각 L40S GPU 세 대인 두 풀에서 vLLM 0.31.0, Qwen-3.8-27B-FP8, GuideLLM 0.8.1을 사용했다. 기준은 새 연결마다 pod를 무작위 선택하는 Kubernetes Service다. 다른 캐시 인식 라우터가 아니다.
공급사는 공유 접두부에서 TTFT 중앙값이 6.88초에서 0.31초로, 전체 지연 중앙값이 20.5초에서 11.3초로 줄었다고 보고한다. 독립 입력의 TTFT 중앙값은 거의 같다. 최대 goodput은 분당 14에서 103요청이지만 최대점의 동시성은 다르다. goodput은 지연 목표를 지킨 요청만 센다. 여기서는 첫 token의 90%가 8초 안에 도착해야 하며 Buoyant도 대화형 채팅에는 부적합한 목표라고 한다.
다른 GPU, 짧은 입력, 더 엄격한 목표나 기존 지능형 라우터에서도 같은 이득을 보장하지 않는다. 자기 요청들이 실제로 얼마나 많은 맥락을 공유하는지가 먼저다.
요청은 여전히 gateway가 운반한다
be2a7ad로 고정한 README는 Buoyant Gateway 같은 proxy와 결합하는 제어 계층을 설명한다. gRPC는 목적지와 필요시 수정한 body를 반환하며 추론 엔진을 대체하지 않는다.
요청 흐름은 body 전달, 선택 요청, 출력 body 회수, worker 전달 뒤 첫 token과 마지막 token 보고로 이어진다. 이 피드백이 예측과 관측을 연결한다. 완료, 중단, 보고가 없을 때의 만료 정리가 배치 후 남은 임시 상태를 해제한다.
URL 변경은 앱에 보이는 부분일 뿐이다. gateway, router, 엔진 관측이 협력해야 한다. 구조 문서는 worker 발견, 캐시 추적, 점수 계산, Kubernetes 감시를 나눈다. GPU 사용률 그래프만으로 접두부 일치나 완료 보고가 정확하다고 판단할 수 없다.
alpha는 제품 설명보다 작다
Token 제한과 의미 분류 페이지는 향후 릴리스 기능이라고 명시한다. README는 장기 운영 경험이 없다고 경고하며 위 기능, Anthropic 방식 /v1/messages, 여러 Kinference 복제본을 미지원으로 적는다. 복제본은 제어 계층 이야기이지 벤치마크의 여러 vLLM worker가 아니다.
반면 고정한 구조 문서는 복제본 리더 선출을 설명한다. 이 문서 차이가 고가용성 지원을 입증하지 않는다. 코드, 설계, 지원하는 운영 모드는 다른 속도로 발전할 수 있다.
민감도 태그가 있는 정책 예시도 정확한 분류기의 출시 증거는 아니다. 태그 이후의 결정과 태그 생성 정확도는 별개다. 이 글은 릴리스 해설이지 직접 시험한 도입 권고가 아니다. 할당량, 프로토콜, 이중화는 버전별 확인이 필요하다.
Tenant 라벨은 신원 인증이 아니다
Tenant 안내는 설정한 헤더를 무조건 신뢰한다고 한다. 호출자가 값을 마음대로 바꾸면 다른 팀에 사용량을 돌릴 수 있다. 주변 요청 경로가 신뢰할 수 있는 신원을 제공해야 한다.
기본값도 다르다. 안내는 모든 tenant를 기본 추적한다고 하지만 메트릭 참조는 tenant 라벨이 기본 비활성이며 허용 목록을 쓸 수 있다고 적는다. 모델·서비스 등급·tenant 조합마다 약 91개 시계열이 생긴다고 추산한다. 세밀한 집계는 모니터링 비용도 늘린다.
어느 기본값도 검증된 동작으로 단정하지 않는다. 실제 버전과 설정을 봐야 한다. tenant 메트릭의 존재는 사용량 제한을 집행한다는 증거도 아니다.
응답 성공과 라우팅 품질은 다르다
고정한 요청 문서에 따르면 모든 token화 경로가 실패하면 부하만으로 점수를 매길 수 있다. 메트릭은 token화 가용성, 저하된 점수 계산, 예측 지연을 노출한다. 텍스트가 돌아와도 캐시 인식 배치가 작동했다는 뜻은 아니다. 캐시 사용량 보고 누락도 사용량 0과 구별해야 한다.
NxCode 독자에게 중요한 관점은 지연이 모델 이름만의 속성이 아니라 변화하는 풀을 지나는 요청의 속성이라는 점이다. Kinference는 그 일부를 보이게 한다. 다음 증거는 명확한 지원 버전과 다른 실제 부하에서 응답 성공 및 라우팅 품질을 함께 측정한 결과다.
출처
- Kinference team: November 4 release.
- Kinference: cache-aware load balancing.
- Buoyant: published benchmark and conditions.
- Kinference: pinned README and limitations.
- Kinference: pinned request flow.
- Kinference: pinned architecture.
- Kinference: token limiting status.
- Kinference: semantic classification status.
- Kinference: tenant identification.
- Kinference: metrics reference.