

Kinference把vLLM請求送向已經做過的計算
對話的第二次請求並非從空白開始。GPU叢集中可能已有一個worker處理過大部分歷史;下一輪若送到別處,叢集就得重做已有的計算。
這是Buoyant 11月4日發布Kinference處理的問題。vLLM仍負責執行模型,Kinference在上方決定請求去向。三個健康worker不再完全等價,它嘗試預測哪個能最快為這個提示回傳第一個token。
程式開發會話不斷傳送專案背景,特別容易遇到這種情形。但特定流量的成績不等於所有GPU都會加速,產品方向也不等於alpha已全部交付。NxCode解讀公開資料,未安裝Kinference、操作GPU叢集或重現benchmark。
下一輪對話也有位置
KV cache儲存已處理token的注意力中間計算。重用符合的前綴可減少prefill,即產生回答前讀取輸入的運算。它並非完整答案快取,後續文字仍須生成。
快取路由文件說明,Kinference追蹤每個vLLM worker的快取內容與負載;vLLM須透過ZMQ訊息傳輸發送快取事件。路由器據此預測各端點對特定提示的TTFT,也就是首個token抵達前的時間。
想像兩個worker執行相同模型:A已有共同專案說明的快取,但佇列較長;B沒有符合前綴,卻較空閒。只看命中率無法決定,因為等A可能比在B重新計算更慢。Kinference希望同時衡量重用與等待,不是永遠選最熱的快取。
開發者因此多了一個解釋延遲的角度。權重、提示相同,分配位置仍會改變重複輸入運算量。換更快模型只是可以調查的其中一條路。
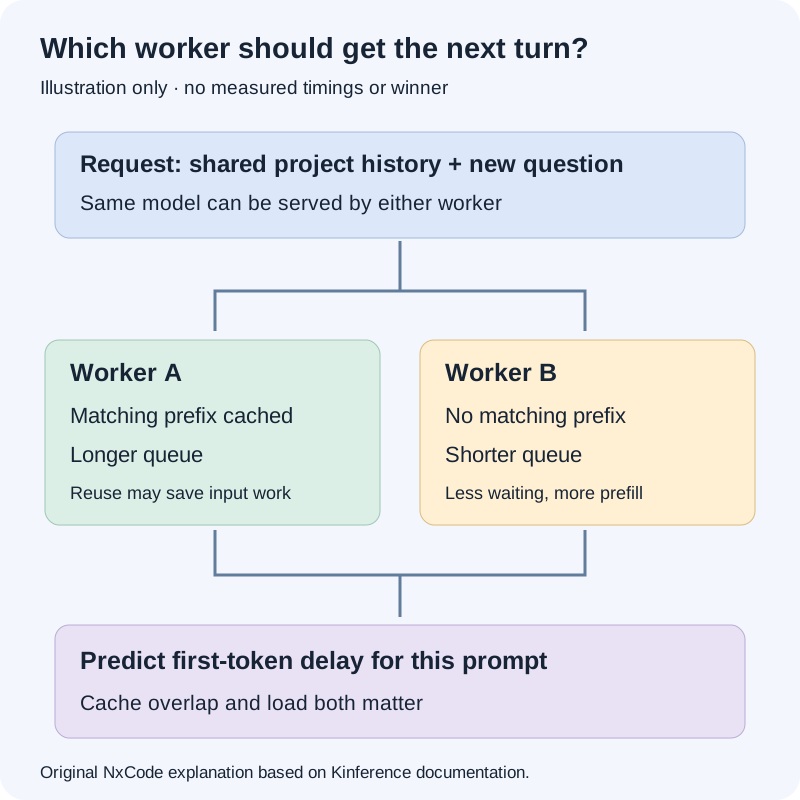
圖:NxCode依Kinference文件繪製的原創解釋圖。候選worker僅供說明,並非benchmark軌跡或實測路由決策。
測試標題有特定比較對象
Buoyant官方benchmark比較兩個各有三張L40S的池,執行vLLM 0.31.0與Qwen-3.8-27B-FP8,用GuideLLM 0.8.1產生流量。基線是每次新連線隨機選pod的Kubernetes Service,不是另一個快取感知路由器。
廠商報告,共享前綴流量的TTFT中位數由6.88秒降至0.31秒,端到端中位延遲由20.5降至11.3秒;獨立提示的TTFT中位數大致不變。共享前綴峰值goodput從14增至103請求/分鐘,但兩個峰值的並行度不同。goodput只算符合延遲目標的請求,並非所有完成請求。該組SLO要求90%的首字於8秒內抵達,Buoyant亦說這不適合即時聊天。
條件就是結果的一部分。它支持該負載優於該基線,無法證明更換GPU、縮短提示、收緊目標或對比既有智慧路由器後仍有相同增益。
讀者應先看自己的請求形狀。重複背景帶來重用機會;彼此無關的輸入是另一場實驗。值得量測的是省下多少重複輸入運算,以及佇列是否仍受控。
請求仍由閘道送出
固定於be2a7ad的README描述Kinference搭配Buoyant Gateway等代理。gRPC介面接收請求,回傳目的地與可能修改的內容。這是分工,不是取代引擎。
請求流程文件寫明:閘道推送請求內容、要求選點、取回待送內容,再轉發給worker;之後回報第一個與最後一個token。預測才有機會與實際結果對照。
每次分配會留下暫時狀態,包括預測等待與已派工作。完成、中止回報可釋放紀錄;呼叫端不回報時還有逾時回收。因此客戶端改URL只是表層,平台得讓閘道、路由器與引擎觀測協作。
架構文件分開說明worker探索、快取追蹤、評分與Kubernetes資源監看。檢查主張時可找到對應元件。GPU使用率圖本身不能證明提示匹配準確,也不能證明閘道正確回報完成。
alpha小於產品描述
官網談路由、限流、分類平台,但按token限流和語義分類功能頁都標明未來版本才提供。
固定README亦說軟體尚無長期正式環境經驗,列出上述功能、Anthropic風格/v1/messages與多個Kinference副本支援仍缺少。此處副本是控制面副本,別與測試的多個vLLM worker混淆。
另一方面,固定架構已討論副本選主。這是文件張力,不能據此宣布高可用受支援。程式路徑、設計文件與受支援的運作模式可能進度不同。
策略範例寫出敏感內容標籤,也不表示已交付可靠分類器。範例解釋已有標籤後如何決策,沒有量測產生標籤的準確性。
這篇是發布解讀,並非親測採用建議。仰賴配額、特定協定、控制面備援的團隊,需要逐版本確認,不能讓發布標題代答。
租戶標籤不是身分驗證
租戶指南說Kinference無條件信任設定的請求標頭。若呼叫者可任意修改,用量就可能記到別的租戶。讀標籤與驗證呼叫者是兩個動作。
內部模型服務若要讓團隊帳務有意義,周邊請求路徑必須供應使用者不能隨意改寫的身分。讀取標頭的行為並未解決這層信任。
指標預設值也互相衝突:租戶指南說預設追蹤全部租戶,指標參考卻說逐租戶標籤預設關閉,並說明允許清單。後者估計每個模型、服務品質等級與租戶組合約產生91條時間序列。較細的歸屬資訊也有監控成本。
本文不自行選一個預設值當成驗證過的行為。部署需核對實際版本、設定;存在租戶指標也不等於目前已強制執行租戶上限。
請求成功,路由仍可能降級
固定流程文件說,所有分詞途徑都失敗時,評分可以退回只看負載,而非拒絕選點。指標參考提供分詞可用性、降級評分與預測延遲。因此模型能成功回傳文字,同時失去快取感知分配。
這比單一健康燈更有資訊:模型有沒有回答,與路由器是否取得預期決策需要的資料,必須分開。worker未回報快取用量也應獨立記錄,不代表完全未用快取。
對以推論打造產品的NxCode讀者,關鍵在於延遲屬於請求穿越動態叢集的過程,不只掛在模型名字上。Kinference讓部分環節可見、可設定;alpha狀態與文件衝突仍是故事的一部分。下一步有意義的證據,是明確受支援的版本,以及另一種真實負載上同時檢查回答成功與路由品質的量測。
資料來源
- Kinference team: November 4 release.
- Kinference: cache-aware load balancing.
- Buoyant: published benchmark and conditions.
- Kinference: pinned README and limitations.
- Kinference: pinned request flow.
- Kinference: pinned architecture.
- Kinference: token limiting status.
- Kinference: semantic classification status.
- Kinference: tenant identification.
- Kinference: metrics reference.