

Kinference把vLLM请求送向已经做过的计算
对话里的第二次请求并不是从空白开始。GPU集群中可能已有一个worker处理过大部分历史。如果下一轮去了别处,集群就要重做已有的计算。
这正是Buoyant 11月4日发布Kinference要解决的问题。vLLM仍负责运行模型,Kinference在它上方决定请求去哪里。三个健康worker不再被视为完全等价;它尝试预测哪个能最快为当前提示返回第一个token。
编码会话反复发送项目背景,特别容易遇到这种情况。但某种流量的好成绩不等于所有GPU都提速,产品方向也不等于alpha已全部实现。NxCode解读公开材料,未安装Kinference、操作GPU集群或复现benchmark。
下一轮对话也有位置
KV cache保存已经处理过的token对应的注意力中间计算。复用匹配前缀可以减少prefill,也就是生成回答前读取输入的计算。它不是完整答案缓存,后续文本仍要生成。
缓存路由文档说明,Kinference跟踪每个vLLM worker的缓存与负载;vLLM需要经ZMQ消息传输发送缓存事件。路由器据此预测某个提示在各端点的TTFT,即首个token到达前的时间。
设想两个worker运行相同模型:A缓存了共同项目说明,但排队更长;B没有匹配前缀,却更空闲。只看命中率不够,因为等A可能比在B重算还慢。Kinference试图同时考虑复用和等待,而非总选缓存最热的机器。
应用开发者因此多了一种解释延迟的办法。权重和提示完全相同,分配位置不同,也会改变重复输入计算量。换更快的模型并非唯一可以调查的方向。
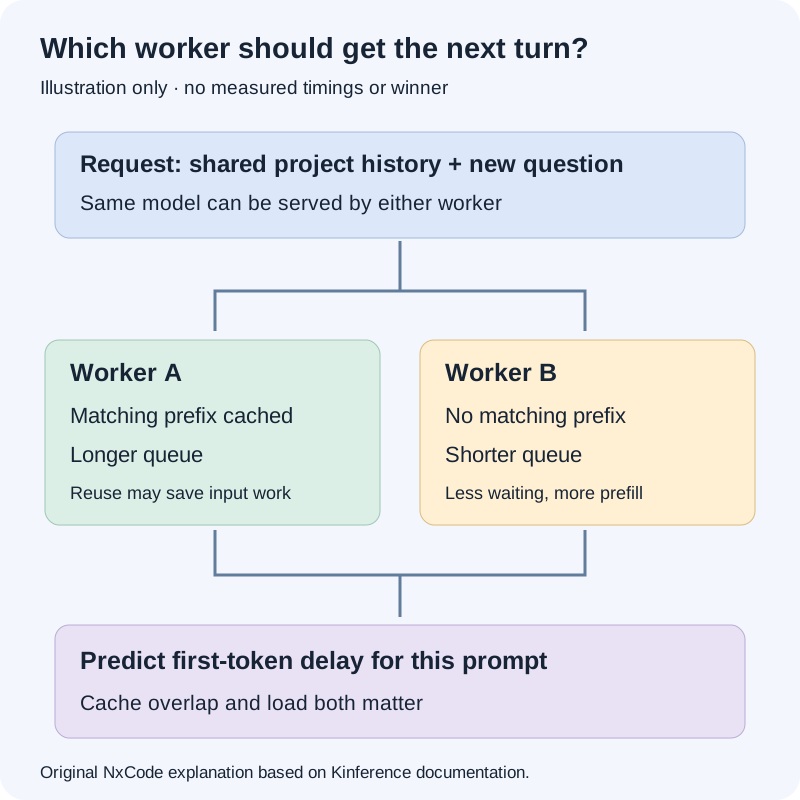
图:NxCode依据Kinference文档绘制的原创解释图。候选worker仅作说明,不是benchmark轨迹,也不是实测路由决策。
跑分标题有特定比较对象
Buoyant官方benchmark比较两个各含三张L40S的池,运行vLLM 0.31.0与Qwen-3.8-27B-FP8,使用GuideLLM 0.8.1发流量。基线是按新连接随机选pod的Kubernetes Service,并非另一个缓存感知路由器。
厂商报告,共享前缀流量的中位TTFT从6.88秒降到0.31秒,端到端中位延迟从20.5秒降到11.3秒;独立提示的中位TTFT基本没有变化。共享前缀峰值goodput从14增到103请求/分钟,但峰值发生在不同并发度。goodput只算符合延迟目标的请求,不是全部完成请求。该组SLO要求90%的首字在8秒内到达,Buoyant也说明它不适合实时聊天。
这些条件就是结果的一部分。它支持特定负载下优于该基线的判断,不能证明换GPU、缩短提示、收紧目标或对比已有智能路由器后仍有同样增益。
读者应先看自己的请求形态。重复背景带来复用机会;几乎无关的输入则是另一场实验。真正要测的是少做了多少重复输入计算,以及队列是否仍受控。
请求仍由网关送出
固定到be2a7ad的README描述Kinference与Buoyant Gateway等代理配合。它的gRPC接口接收请求,返回目标和可能修改过的请求体。模型计算仍归推理引擎负责。
请求流程文档把过程拆清:网关推送请求体、请求选点、取回待发送内容,再转发到worker;之后回报首个token与最后一个token。这样才有机会把预测与实际结果对应起来。
一次分配会留下临时状态:预测的等待,以及已派出的工作。完成和中止回报让路由器释放这些记录;调用方不再回报时,文档还描述了超时回收。因此客户端改URL只是表面变化,平台需要让网关、路由器和引擎观测协同工作。
架构文档分别说明发现worker、跟踪缓存、评分和监听Kubernetes资源的职责。检查某项能力时,可以据此找到应看的组件。GPU利用率图本身无法证明提示匹配准确,也无法证明网关正确报告完成状态。
alpha比产品描述小一圈
官网描述路由、限流和分类平台,但按token限流与语义分类功能页都明确说会在未来版本提供。
固定README还说项目没有长期生产运行经验,缺少上述两项、Anthropic风格的/v1/messages和多个Kinference副本支持。这里的副本是控制面副本,不能与benchmark里的多个vLLM worker混淆。
同时,固定架构文档已经讨论副本选主。这是资料冲突,不能据此宣布高可用受支持。代码路径、设计说明与受支持运行方式可能处于不同进度。
同理,策略例子里写了敏感内容标签,并不能证明当前分类器会可靠发现敏感内容。例子说明“已有标签后如何决策”,没有测量“标签是否判断正确”。
因此本文是发布解读,不是实测采用建议。依赖配额、特定协议或控制面冗余的团队,需要针对版本逐项确认,发布标题无法代答。
租户标签不是身份认证
租户指南说Kinference无条件信任配置的请求头。如果调用方能随意改值,用量图就可能把流量记到别人名下。读取标签与验证调用者不是同一件事。
内部模型服务要让团队账单有意义,周边请求链必须提供不能由用户任意改写的身份。Kinference读取请求头的行为没有解决这层信任问题。
指标默认值也存在冲突:租户指南说默认跟踪所有租户,指标参考却说默认关闭逐租户标签,并说明白名单。后者估算每个模型、服务质量等级和租户组合约产生91条时间序列。更细的归属记录也会增加监控负担。
本文没有擅自选一个默认值当作已验证行为。实际部署需要核对版本与配置;有租户指标也不等于当前已经强制执行租户限额。
请求成功,路由仍可能降级
固定请求流程说,当所有分词路径都失败时,评分可退回只看负载,而不拒绝选点。指标参考暴露分词可用性、降级评分与预测延迟。因此模型成功返回文字,仍可能失去缓存感知分配。
这比单一健康灯更有用:模型是否回答,与路由器是否拿到做预期决策的信息,是两件事。worker没上报缓存用量也应单独记录,不能当作“没有使用缓存”。
对围绕推理构建产品的NxCode读者,最值得带走的是:延迟属于请求在动态集群中的旅程,不能只挂在模型名字上。Kinference让其中一些环节可见、可配置;alpha状态与资料冲突仍须保留。下一步有价值的证据,是明确受支持的版本,以及另一种真实负载上同时检查回答成功和路由质量的测量。
资料来源
- Kinference team: November 4 release.
- Kinference: cache-aware load balancing.
- Buoyant: published benchmark and conditions.
- Kinference: pinned README and limitations.
- Kinference: pinned request flow.
- Kinference: pinned architecture.
- Kinference: token limiting status.
- Kinference: semantic classification status.
- Kinference: tenant identification.
- Kinference: metrics reference.