

KinferenceはvLLMのリクエストを計算済みの場所へ送る
会話の2回目のリクエストでは、GPU群のどこかですでに履歴の大部分を処理しているかもしれない。別のworkerへ送れば、その計算を繰り返すことになる。
Buoyantが11月4日に発表したKinferenceは、この配置の問題を扱う。モデルを実行するのはvLLMのままで、Kinferenceは各リクエストをどこへ送るか判断する。コーディングの会話のように長い背景を繰り返し送る用途で意味を持つ。ただし特定の負荷での改善と、あらゆるGPUの高速化は別だ。NxCodeは公開資料を読んでおり、Kinferenceのインストール、GPU運用、測定の再現はしていない。
次のターンにも場所がある
KV cacheは、処理済みtokenの注意機構の中間計算を保持する。共通の先頭部分を再利用すれば、回答を生成する前に入力を読むprefillを減らせる。完成した回答のキャッシュではなく、続きは生成する必要がある。
負荷分散の文書によると、Kinferenceはworkerのキャッシュと負荷を追跡する。vLLMからZMQ経由でキャッシュイベントを送る設定が必要だ。それを使い、ある入力に対するTTFT、つまり最初のtokenまでの時間を予測する。
同じモデルのworker Aにはプロジェクト説明がキャッシュされているが、待ち行列が長い。Bはキャッシュがないが空いている。この例では命中率だけで決められない。Aを待つよりBで計算し直す方が早い場合もある。重みや入力を変えずに、配置だけで重複計算量が変わる。
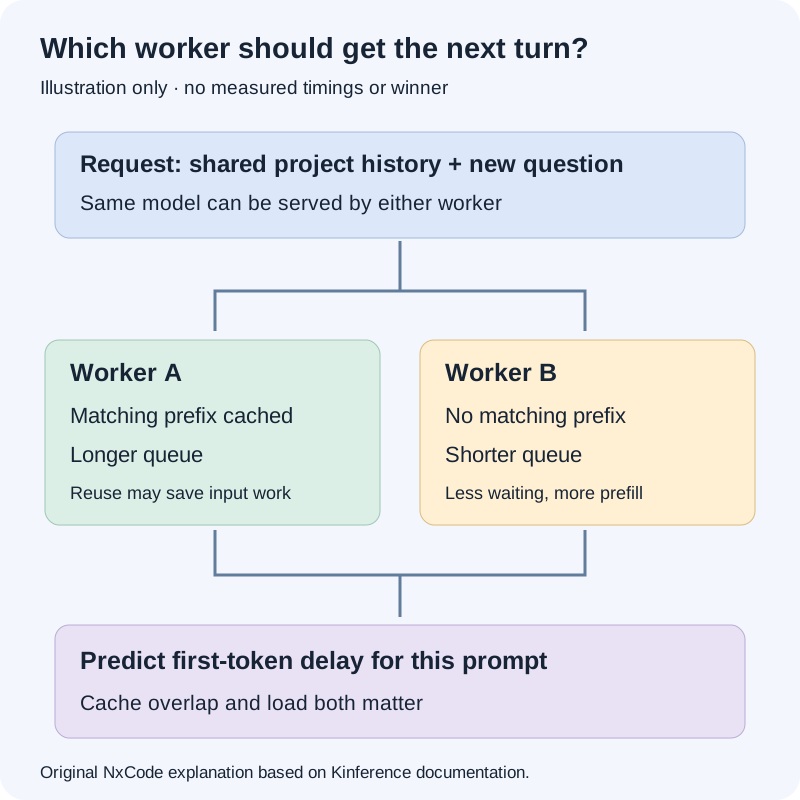
図:Kinference文書に基づくNxCodeの説明図。workerは仮の例であり、benchmarkの軌跡や実測の選択結果ではない。
数字には比較条件がある
Buoyantの測定は、各3基のL40Sを持つ2つのプールでvLLM 0.31.0、Qwen-3.8-27B-FP8、GuideLLM 0.8.1を使用した。比較先は新規接続ごとにpodをランダムに選ぶKubernetes Serviceで、別のキャッシュ対応routerではない。
共有prefixのTTFT中央値は6.88秒から0.31秒、全体の遅延中央値は20.5秒から11.3秒になったという。独立した入力ではTTFT中央値はほぼ変わらない。ピークgoodputは14から103リクエスト/分だが、ピーク時の並行数は異なる。goodputは遅延条件を満たした処理数であり、全完了数ではない。90%の最初のtokenが8秒以内というSLOで、発表元も対話チャットには不向きな条件とする。
異なるGPU、短い入力、厳しい目標、既存の賢いrouterでも同じ改善になる証明ではない。自分のトラフィックがどれだけ背景を再利用するかが、次の測定の出発点になる。
リクエストを運ぶのはgateway
be2a7adに固定したREADMEでは、KinferenceはBuoyant Gatewayなどのproxyと組み合わせる制御プレーンだ。gRPCで入力を受け、送信先と必要に応じて変更したbodyを返す。推論エンジンそのものを置き換えない。
処理順序はbody送信、選択要求、出力body取得、workerへの転送、最初と最後のtokenの報告となる。予測と実際を結び付けるのはこの報告だ。分配は一時的な状態を残すため、完了、中止、報告がない場合の期限切れ回収も重要になる。
アプリがURLを変更するだけでも、その下ではgateway、router、エンジンの観測が連携しなければならない。アーキテクチャ文書はworker発見、キャッシュ追跡、評価、Kubernetes監視を分ける。GPU使用率のグラフだけで、prefix照合や完了報告が正しいとは判断できない。
alphaの範囲は製品説明より狭い
Token制限と意味分類のページは、将来のリリースで提供すると明記する。READMEも長期の本番稼働経験がないとし、この2機能、Anthropic形式の/v1/messages、複数Kinferenceレプリカを未対応に挙げる。後者は制御面の複数化であり、測定の複数vLLM workerとは違う。
一方、固定した設計文書にはレプリカのリーダー選出がある。この食い違いを、高可用性がサポートされた証拠にはしない。実装経路、設計、保証される運用方法は進み方が違うことがある。
機密情報タグを使うpolicy例も、出荷済み分類器の精度を示さない。タグが存在する場合の判断と、タグを正確に付ける能力は別だ。これは公開資料の解説であり、実測に基づく導入推奨ではない。quota、プロトコル、冗長化に依存するなら版ごとの確認が要る。
テナントのラベルは本人確認ではない
テナントガイドは設定したheaderを無条件に信頼すると説明する。利用者が自由に値を変えられれば、別のチームに使用量を付けられる。ラベルを読むことと呼び出し元を認証することは違う。周辺のリクエスト経路が信頼できるIDを与える必要がある。
既定値も一致しない。ガイドは全テナントを既定で追跡すると書くが、metrics参照はテナント別ラベルは既定で無効としてallowlistを説明する。後者はモデル・サービス品質クラス・テナントの組ごとに約91時系列を見込む。細かい計測には監視側の負担もある。
どちらかを検証済みの挙動として選ばず、実際の版と設定を確認すべき差として残す。テナント別metricsがあることは、利用上限が強制される証拠でもない。
応答が成功してもroutingは劣化し得る
固定した処理文書では、すべてのtoken化経路が失敗すると負荷だけで評価を続けられる。metricsはtoken化の利用可否、劣化した評価、予測遅延を示す。文字が返ってきてもキャッシュを考慮した分配が働いたとは限らない。キャッシュ使用量の未報告も、使用ゼロとは区別が必要だ。
NxCode読者にとっての要点は、遅延がモデル名だけの性質ではなく、変化するGPU群を通るリクエストの性質だということ。Kinferenceはその一部を見えるようにする。次に欲しいのは明確なサポート範囲と、別の実負荷で応答成功とrouting品質を同時に確かめた結果だ。
出典
- Kinference team: November 4 release.
- Kinference: cache-aware load balancing.
- Buoyant: published benchmark and conditions.
- Kinference: pinned README and limitations.
- Kinference: pinned request flow.
- Kinference: pinned architecture.
- Kinference: token limiting status.
- Kinference: semantic classification status.
- Kinference: tenant identification.
- Kinference: metrics reference.