

Kinference stuurt vLLM naar werk dat al is gedaan
Het tweede verzoek in een gesprek begint niet bij nul. Een worker in de GPU-pool heeft mogelijk al bijna de hele geschiedenis verwerkt. De volgende beurt elders bezorgen kan dat werk herhalen.
Buoyant kondigde Kinference op 4 november aan. vLLM blijft het model uitvoeren; Kinference kiest de bestemming. Dat is interessant voor programmeersessies met terugkerende projectcontext. Winst op één verkeerspatroon versnelt echter niet alle GPU’s. NxCode las de openbare stukken, maar installeerde Kinference niet, beheerde geen cluster en reproduceerde de benchmark niet.
Ook de volgende beurt heeft een locatie
De KV-cache bewaart tussenberekeningen van attention voor verwerkte tokens. Een overeenkomend prefix hergebruiken bespaart prefill, het lezen van de invoer vóór generatie. Het is geen cache van complete antwoorden: de voortzetting moet nog ontstaan.
De cachedocumentatie beschrijft het volgen van cache-inhoud en belasting per worker. vLLM moet cachegebeurtenissen via ZMQ publiceren. Kinference voorspelt daarmee TTFT, de tijd tot het eerste token, voor die invoer per bestemming.
Stel dat A de projectinstructies al heeft, maar een lange wachtrij. B heeft geen overeenkomstig prefix, maar is vrij. Wachten op A kan duurder zijn dan opnieuw rekenen op B. Alleen een cachetreffer beslist dus niet. Gelijke gewichten en gelijke invoer kunnen door andere plaatsing verschillend veel dubbel werk veroorzaken.
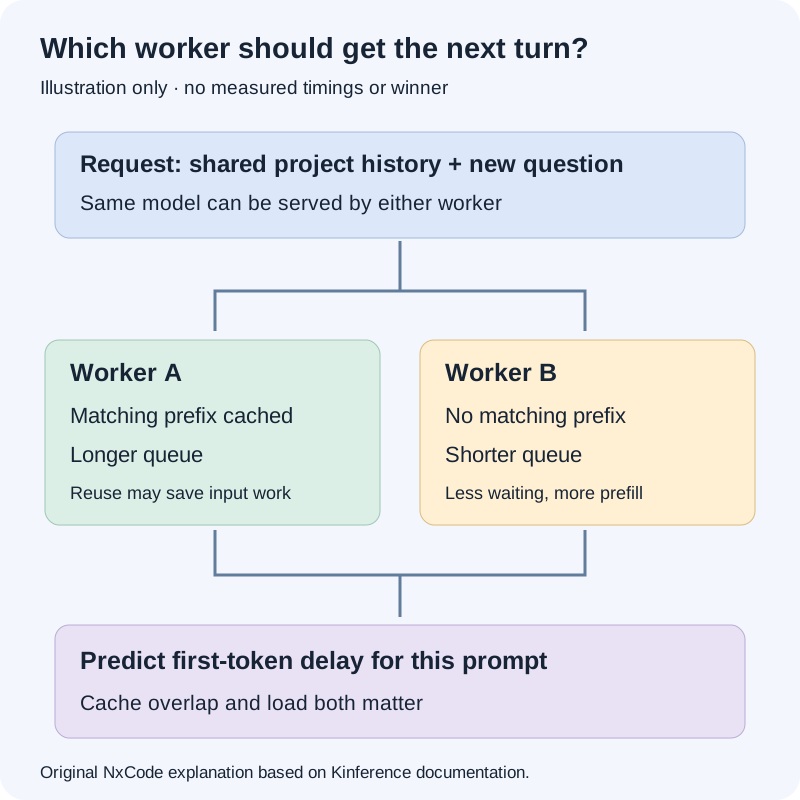
Figuur: eigen uitleg van NxCode op basis van Kinference-documentatie. De workers zijn illustratief, geen benchmarkregistratie of gemeten routeringskeuze.
De kop heeft een specifieke vergelijking
Buoyants benchmark gebruikt twee pools van elk drie L40S-GPU’s met vLLM 0.31.0, Qwen-3.8-27B-FP8 en GuideLLM 0.8.1. De referentie is Kubernetes Service met willekeurige podkeuze per nieuwe verbinding, geen andere cachebewuste router.
De leverancier meldt bij gedeelde prefixes een mediane TTFT van 6,88 naar 0,31 seconde en een mediane totale vertraging van 20,5 naar 11,3 seconden. Bij onafhankelijke invoer blijft de mediane TTFT ongeveer gelijk. De piek-goodput stijgt van 14 naar 103 verzoeken per minuut, bij verschillende gelijktijdigheden. Goodput telt alleen verzoeken binnen het latentiedoel: 90% eerste tokens binnen acht seconden. Buoyant noemt dat ongeschikt voor interactieve chat.
Dit bewijst niet dezelfde winst op andere hardware, korte invoer, strengere doelen of tegenover een bestaande slimme dispatcher. Eerst moet duidelijk zijn hoeveel context de eigen verzoeken werkelijk delen.
De gateway vervoert het verzoek nog steeds
De README vastgezet op be2a7ad beschrijft besturing naast een proxy zoals Buoyant Gateway. De gRPC-interface retourneert een bestemming en eventueel aangepaste body. Zij vervangt de inferentie-engine niet.
De verzoekstroom verstuurt de body, vraagt om een keuze, haalt de uitgaande body op en stuurt die naar de worker. Daarna meldt de gateway het eerste en laatste token. Zo worden voorspelling en uitkomst gekoppeld. Afronding, afbreken en verlopen ruimen tijdelijke toewijzingsstatus op.
Een andere URL is slechts het zichtbare deel voor de app. Gateway, router en engine-observaties moeten samenwerken. De architectuur scheidt workerontdekking, cachetracking, beoordeling en Kubernetes-bewaking. Een GPU-grafiek bewijst geen correcte prefixherkenning of juiste afrondingsmelding.
De alpha is kleiner dan de productbeschrijving
De pagina’s over tokenlimieten en semantische classificatie noemen een toekomstige versie. De README waarschuwt voor ontbrekende langdurige productie-ervaring en noemt ook Anthropic-achtige /v1/messages en meerdere Kinference-replica’s als ontbrekend. Die replica’s horen bij de besturing, niet bij de meerdere vLLM-workers in de test.
De vastgezette architectuur bespreekt al wel leiderverkiezing. Die tegenstelling bewijst geen ondersteunde hoge beschikbaarheid. Code, ontwerp en gegarandeerde bedrijfsvoering kunnen in verschillend tempo groeien.
Een beleidsvoorbeeld met een gevoeligheidslabel bewijst evenmin een geleverde, nauwkeurige classifier. Het beschrijft de keuze ná het label, niet de kwaliteit van het label. Dit is een publicatie-uitleg, geen getest invoeringsadvies. Quota, protocollen en redundantie vragen antwoorden per versie.
Een tenantlabel controleert geen identiteit
De tenantgids zegt dat Kinference een ingestelde header onvoorwaardelijk vertrouwt. Kan de aanroeper die veranderen, dan kan gebruik bij het verkeerde team belanden. Het omliggende verzoekpad moet betrouwbare identiteit leveren.
Ook standaardwaarden botsen: de gids beschrijft standaard alle tenants volgen; de metriekenreferentie noemt tenantlabels standaard uitgeschakeld en beschrijft een toestemmingslijst. Zij schat circa 91 tijdreeksen per combinatie van model, serviceklasse en tenant. Meer detail belast ook de monitoring.
Wij kiezen geen van beide als geverifieerd gedrag. De echte versie en configuratie moeten worden gecontroleerd. Tenantmetrieken bewijzen ook geen afgedwongen tenantlimieten.
Een geslaagd antwoord kan slechter zijn gerouteerd
Volgens de vastgezette stroom kan scoring op alleen belasting terugvallen wanneer alle tokenisatiepaden falen. Metrieken tonen tokenisatiebeschikbaarheid, gedegradeerde scoring en voorspelde vertraging. Tekst ontvangen bewijst dus geen cachebewuste plaatsing. Ontbrekende cachegebruiksrapporten betekenen ook geen nulgebruik.
Voor NxCode-lezers is het nuttige idee dat vertraging hoort bij de reis door een veranderende pool, niet uitsluitend bij een modelnaam. Kinference maakt daar iets van zichtbaar. De volgende relevante stap is een helder ondersteunde versie en een meting op een andere echte belasting die zowel antwoordsucces als routeringskwaliteit bekijkt.
Bronnen
- Kinference team: November 4 release.
- Kinference: cache-aware load balancing.
- Buoyant: published benchmark and conditions.
- Kinference: pinned README and limitations.
- Kinference: pinned request flow.
- Kinference: pinned architecture.
- Kinference: token limiting status.
- Kinference: semantic classification status.
- Kinference: tenant identification.
- Kinference: metrics reference.