

Kinference Mengarahkan vLLM ke Komputasi yang Sudah Dikerjakan
Permintaan kedua dalam percakapan tidak berangkat dari nol. Salah satu worker GPU mungkin telah memproses sebagian besar riwayatnya. Jika giliran berikutnya dikirim ke worker lain, komputasi itu bisa diulang.
Buoyant memperkenalkan Kinference pada 4 November. vLLM tetap menjalankan model; Kinference memilih tujuan permintaan. Ini relevan bagi sesi coding yang terus mengirim konteks proyek. Namun hasil baik pada satu pola trafik bukan percepatan semua GPU. NxCode membaca materi publik tanpa memasang Kinference, mengoperasikan klaster, atau mereproduksi benchmark.
Giliran berikutnya juga memiliki lokasi
KV cache menyimpan komputasi attention sementara untuk token yang sudah diproses. Memakai kembali prefiks yang cocok mengurangi prefill, yaitu membaca masukan sebelum menghasilkan jawaban. Ini bukan cache jawaban jadi; kelanjutannya tetap perlu dihasilkan.
Dokumentasi cache menyebut pelacakan isi cache dan beban tiap worker. vLLM harus mengirim peristiwa cache melalui ZMQ. Kinference lalu memprediksi TTFT, waktu menuju token pertama, bagi masukan itu di setiap endpoint.
Misalkan A menyimpan instruksi proyek, tetapi antreannya panjang. B tidak punya prefiks tersebut, namun lebih lengang. Menunggu A bisa lebih mahal daripada menghitung ulang di B. Kecocokan cache saja tidak menentukan pilihan. Bobot dan masukan identik tetap dapat menimbulkan komputasi berulang yang berbeda karena penempatannya.
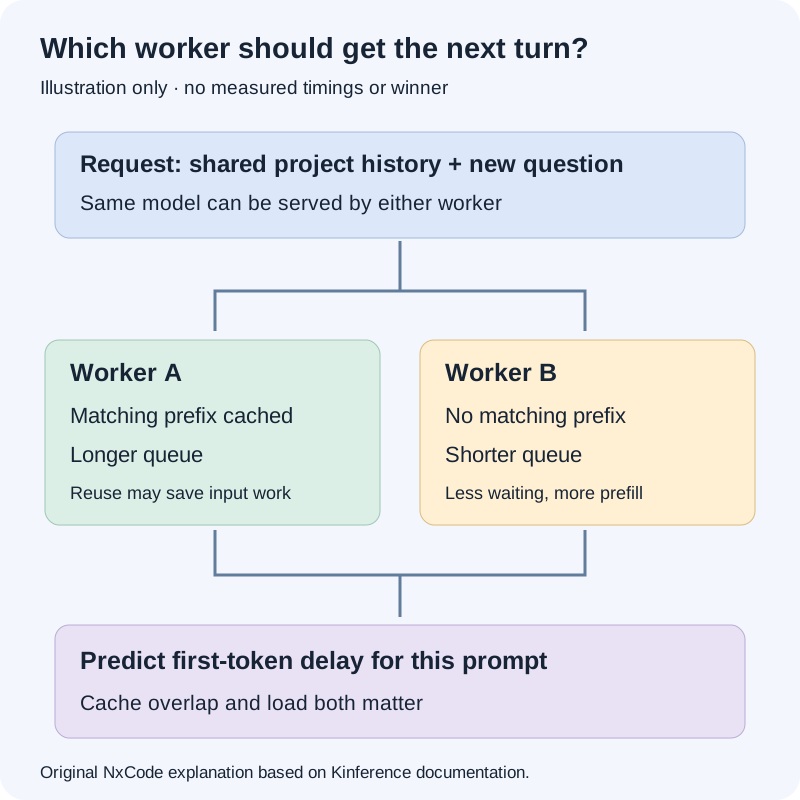
Gambar: penjelasan asli NxCode berdasarkan dokumentasi Kinference. Worker hanya ilustrasi, bukan jejak benchmark atau keputusan routing yang diukur.
Angka utama memiliki pembanding tertentu
Benchmark Buoyant memakai dua pool, masing-masing tiga GPU L40S, vLLM 0.31.0, Qwen-3.8-27B-FP8, dan GuideLLM 0.8.1. Pembandingnya Kubernetes Service yang memilih pod acak per koneksi baru, bukan router lain yang memahami cache.
Vendor melaporkan median TTFT prefiks bersama turun dari 6,88 menjadi 0,31 detik, serta median latensi menyeluruh dari 20,5 menjadi 11,3 detik. Median TTFT masukan independen hampir tidak berubah. Goodput puncak naik dari 14 menjadi 103 permintaan per menit, tetapi puncaknya terjadi pada konkurensi berbeda. Goodput hanya menghitung permintaan yang memenuhi sasaran latensi: 90% token pertama dalam delapan detik. Buoyant menyatakan sasaran ini tidak sesuai untuk chat interaktif.
Hasil itu tidak membuktikan keuntungan sama pada GPU lain, masukan pendek, target lebih ketat, atau router cerdas yang sudah dipakai. Pertanyaan awalnya adalah berapa banyak konteks yang benar-benar berulang dalam trafik sendiri.
Gateway tetap membawa permintaan
README pada commit be2a7ad menjelaskan control plane yang dipasangkan dengan proxy seperti Buoyant Gateway. Antarmuka gRPC mengembalikan tujuan dan mungkin body yang diubah, bukan menggantikan mesin inferensi.
Alur permintaan meliputi pengiriman body, meminta pilihan, mengambil body keluar, lalu meneruskannya ke worker. Gateway kemudian melaporkan token pertama dan terakhir. Pelaporan ini menghubungkan prediksi dengan kejadian nyata. Selesai, batal, dan pembersihan setelah kedaluwarsa membebaskan status sementara dari penugasan.
Mengganti URL hanya bagian yang terlihat oleh aplikasi. Gateway, router, dan pengamatan mesin perlu bekerja bersama. Arsitekturnya memisahkan penemuan worker, pelacakan cache, penilaian, dan pemantauan resource Kubernetes. Grafik utilisasi GPU tidak membuktikan pencocokan prefiks atau laporan selesai sudah benar.
Alpha lebih kecil daripada deskripsi produk
Halaman pembatasan token dan klasifikasi semantik menyebut rilis mendatang. README juga memperingatkan belum adanya pemakaian produksi berkepanjangan, serta mencantumkan /v1/messages bergaya Anthropic dan banyak replika Kinference sebagai kekurangan. Replika ini milik control plane, bukan beberapa worker vLLM dalam benchmark.
Sementara itu, dokumen arsitektur yang dipatok sudah membahas pemilihan pemimpin antarreplika. Ketegangan dokumentasi ini belum membuktikan dukungan high availability. Kode, desain, dan cara operasi yang didukung dapat berkembang dengan kecepatan berbeda.
Contoh policy dengan tag sensitivitas juga tidak membuktikan pengklasifikasi yang tersedia dan akurat. Contoh itu menjelaskan pilihan setelah tag ada, bukan ketepatan menghasilkan tag. Ini ulasan rilis, bukan rekomendasi adopsi berdasarkan uji sendiri. Kuota, protokol, dan redundansi perlu jawaban per versi.
Label tenant bukan autentikasi identitas
Panduan tenant mengatakan Kinference memercayai header terkonfigurasi tanpa syarat. Bila pemanggil bebas mengubahnya, penggunaan dapat dibebankan kepada tim lain. Jalur permintaan di sekitarnya harus memasok identitas yang dapat dipercaya.
Nilai default juga bertentangan: panduan menyebut pelacakan seluruh tenant secara default, sedangkan referensi metrik menyebut label per tenant mati secara default dan menyediakan allowlist. Referensi memperkirakan sekitar 91 time series per kombinasi model, kelas layanan, dan tenant. Atribusi rinci juga membebani pemantauan.
Kami tidak memilih salah satu default sebagai perilaku yang telah diverifikasi. Versi dan konfigurasi nyata harus diperiksa. Adanya metrik tenant pun tidak membuktikan batas penggunaan telah ditegakkan.
Jawaban berhasil dapat menyembunyikan routing yang menurun
Alur yang dipatok menjelaskan bahwa jika semua jalur tokenisasi gagal, penilaian dapat memakai beban saja, alih-alih menolak pilihan. Metrik mengekspos ketersediaan tokenisasi, penilaian terdegradasi, dan prediksi latensi. Teks yang berhasil kembali belum membuktikan cache dipakai untuk penempatan. Laporan penggunaan cache yang hilang juga tidak sama dengan penggunaan nol.
Bagi pembaca NxCode, gagasan utamanya ialah latensi mengikuti perjalanan permintaan melalui kumpulan worker yang berubah, bukan sekadar nama model. Kinference membuat sebagian perjalanan terlihat. Bukti berikutnya yang penting adalah versi dengan dukungan jelas serta pengukuran pada beban nyata lain, yang menilai keberhasilan jawaban sekaligus kualitas routing.
Sumber
- Kinference team: November 4 release.
- Kinference: cache-aware load balancing.
- Buoyant: published benchmark and conditions.
- Kinference: pinned README and limitations.
- Kinference: pinned request flow.
- Kinference: pinned architecture.
- Kinference: token limiting status.
- Kinference: semantic classification status.
- Kinference: tenant identification.
- Kinference: metrics reference.
