

Kinference envía vLLM hacia el trabajo que ya está hecho
La segunda petición de una conversación no empieza desde cero. Algún worker del conjunto de GPU quizá ya procesó casi todo el historial. Mandar la continuación a otro puede repetir ese trabajo.
Buoyant presentó Kinference el 4 de noviembre. vLLM sigue ejecutando el modelo; Kinference decide adónde va cada petición. Esto importa en sesiones de programación que repiten el contexto del proyecto. Pero mejorar una carga concreta no acelera universalmente las GPU. NxCode ha leído los materiales públicos; no ha instalado Kinference, operado un clúster ni reproducido el benchmark.
El siguiente turno también tiene ubicación
La KV cache guarda cálculos intermedios de atención de tokens ya procesados. Reutilizar un prefijo coincidente reduce el prefill, el trabajo de leer la entrada antes de generar. No guarda respuestas terminadas: la continuación aún debe producirse.
La documentación de caché describe el seguimiento del contenido y la carga por worker. vLLM debe emitir eventos mediante ZMQ. Con ello se predice el TTFT, tiempo hasta el primer token, para esa entrada en cada destino.
Imaginemos que A tiene las instrucciones del proyecto en caché, pero una cola larga. B carece del prefijo y está más libre. Esperar a A puede costar más que recalcular en B. El acierto de caché por sí solo no resuelve la elección. Mismos pesos y misma entrada pueden causar distinto trabajo repetido según la asignación.
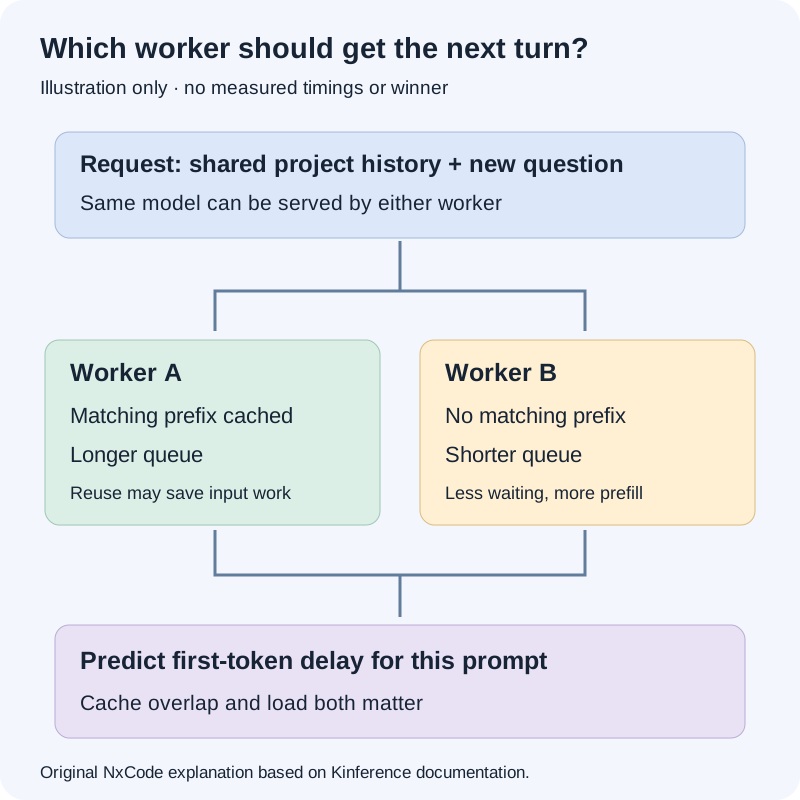
Figura: explicación original de NxCode basada en documentación de Kinference. Workers ilustrativos; no es una traza de benchmark ni una decisión medida.
El titular depende de la comparación
El benchmark de Buoyant usa dos grupos de tres GPU L40S, vLLM 0.31.0, Qwen-3.8-27B-FP8 y GuideLLM 0.8.1. La referencia es Kubernetes Service con elección aleatoria de pod por conexión nueva, no otro router consciente de la caché.
El proveedor comunica un TTFT mediano de 6,88 a 0,31 segundos para prefijos compartidos y latencia total mediana de 20,5 a 11,3 segundos. Con entradas independientes, el TTFT mediano apenas cambia. El goodput máximo pasa de 14 a 103 peticiones por minuto, pero los máximos corresponden a concurrencias diferentes. Solo cuenta peticiones dentro del objetivo de latencia: 90 % de primeros tokens en ocho segundos. Buoyant considera ese objetivo inadecuado para chat interactivo.
No prueba igual mejora en otra GPU, con entradas cortas, objetivos más estrictos o frente a un distribuidor inteligente existente. Primero conviene saber cuánto contexto comparten las peticiones propias.
La puerta de enlace aún transporta la petición
El README fijado en be2a7ad describe un control que se combina con un proxy como Buoyant Gateway. La interfaz gRPC devuelve destino y, si corresponde, cuerpo modificado. No sustituye al motor.
El flujo documentado envía el cuerpo, solicita una selección, recupera el cuerpo saliente y lo reenvía al worker. Después informa del primer y último token. Estos informes conectan previsión y resultado. Finalización, cancelación y caducidad liberan el estado temporal dejado por la asignación.
Cambiar la URL es solo la parte visible para la aplicación. Gateway, router y observaciones del motor deben cooperar. La arquitectura separa descubrimiento, seguimiento de caché, puntuación y vigilancia de recursos Kubernetes. Un gráfico de utilización GPU no demuestra coincidencias correctas ni informes de finalización fiables.
La alpha es menor que la descripción del producto
Las páginas de límites por token y clasificación semántica dicen que llegarán en una versión futura. El README advierte que no existe experiencia sostenida en producción y enumera también /v1/messages de estilo Anthropic y múltiples réplicas Kinference como pendientes. Esas réplicas son del control, no los varios workers vLLM del benchmark.
Sin embargo, la arquitectura fijada ya describe elección de líder entre réplicas. La discrepancia no demuestra alta disponibilidad soportada: código, diseño y modo de operación respaldado pueden avanzar a distinto ritmo.
Una regla que usa etiquetas de sensibilidad tampoco demuestra un clasificador entregado y preciso. Explica la decisión cuando existe una etiqueta, no su exactitud. Este artículo interpreta una publicación, no recomienda una adopción probada. Cuotas, protocolos y redundancia requieren confirmación por versión.
La etiqueta de un tenant no autentica al usuario
La guía de tenants dice que Kinference confía incondicionalmente en una cabecera configurada. Si el usuario puede alterarla, el consumo puede atribuirse a otro equipo. La cadena de peticiones debe proporcionar una identidad fiable.
También discrepan los valores predeterminados: la guía habla de seguimiento de todos los tenants; la referencia de métricas dice que las etiquetas por tenant están desactivadas y explica una lista permitida. Estima unas 91 series temporales por combinación de modelo, clase de servicio y tenant. El detalle también carga el sistema de monitorización.
No elegimos uno de esos valores como conducta verificada. Hay que comprobar versión y configuración. Tener métricas por tenant tampoco prueba que existan límites obligatorios por tenant.
Una respuesta correcta puede tener routing degradado
El flujo fijado permite puntuar solo por carga si fallan todas las vías de tokenización. Las métricas exponen disponibilidad, puntuación degradada y latencia prevista. Que vuelva texto no prueba que el router haya usado la caché. La ausencia de datos sobre consumo de caché tampoco equivale a consumo cero.
Para lectores de NxCode, la idea útil es que la latencia pertenece al recorrido de una petición por un conjunto cambiante, no solo al nombre del modelo. Kinference hace visible parte del recorrido. Lo siguiente que merece atención es una versión claramente respaldada y mediciones en otra carga real que observen tanto respuestas completadas como calidad de asignación.
Fuentes
- Kinference team: November 4 release.
- Kinference: cache-aware load balancing.
- Buoyant: published benchmark and conditions.
- Kinference: pinned README and limitations.
- Kinference: pinned request flow.
- Kinference: pinned architecture.
- Kinference: token limiting status.
- Kinference: semantic classification status.
- Kinference: tenant identification.
- Kinference: metrics reference.